Domain gemeinhin.de kaufen?
Wir ziehen mit dem Projekt
gemeinhin.de um.
Sind Sie am Kauf der Domain
gemeinhin.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain gemeinhin.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
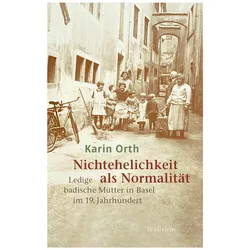
Nichtehelichkeit als Normalität, Fachbücher von Karin Orth»Unehelichkeit« als Normalität in der Mitte des 19. Jahrhunderts: Eine mikrohistorische Studie über Familie und Sexualität. Ausserhalb der Ehe geborene Kinder stellen heute keine Besonderheit dar. Ganz anders vor 200 Jahren: Im frühen 19. Jahrhundert stieg die Rate der unehelichen Kinder von zuvor zwei bis vier Prozent auf nun über 20 Prozent an, lokal – etwa im Südwesten des Grossherzogtums Baden – sogar auf über 60 Prozent. Dieser enorme Anstieg wurde registriert, vielfach kommentiert und von bürgerlicher wie kirchlicher Seite häufig als bedrohlich empfunden. Karin Orth untersucht an zwei regionalen badischen Fallbeispielen und der Schweizer Metropole Basel die strukturellen Ursachen dieses Anstiegs und zeigt die Praktiken, Erfahrungen und Auswirkungen der »Illegitimität« auf: »Männerbekanntschaften« und der nichteheliche »Beyschlaf«, (verheimlichte) Schwangerschaft und Niederkunft, »Kindsaussetzung« und »Kindsmord« sowie das Gebären im Basler Bürgerspital. Im Zentrum stehen rund 400 ledige junge Frauen aus dem badischen Südwesten. Sie waren mehrheitlich in unterbäuerlichen Familien aufgewachsen, die in Baden »Unehelichkeit« als Normalität lebten, und transferierten dieses Muster der nichtehelichen Familiengründung nach Basel. An ihrem Beispiel wird der Mikrokosmos der »Unehelichkeit« exemplarisch analysiert.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
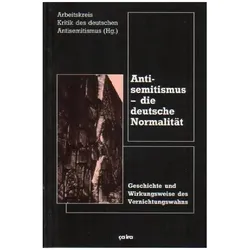
Antisemitismus - die deutsche Normalität, Fachbücher von Hans SteidleDas Buch "Antisemitismus - die deutsche Normalität" von Hans Steidle bietet eine tiefgehende Analyse des Antisemitismus in Deutschland und dessen Verknüpfung mit gesellschaftlichen Strukturen. Es beleuchtet die Singularität der deutschen Tat Auschwitz und stellt diese in den Kontext der bürgerlichen Kälte sowie der spätkapitalistischen Vergesellschaftungsformen. Steidle fordert eine kritische Auseinandersetzung mit der deutschen Geschichte und deren Auswirkungen auf die gegenwärtige Gesellschaft. Durch die Verbindung von historischen und gesellschaftlichen Aspekten wird ein umfassendes Bild des Antisemitismus gezeichnet, das zum Nachdenken anregt und zur Diskussion einlädt. Dieses Fachbuch richtet sich an alle, die sich mit der Thematik des Antisemitismus und dessen gesellschaftlichen Wurzeln auseinandersetzen möchten.26,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was bedeutet es, gewöhnlich zu sein und wie unterscheidet sich Gewöhnlichkeit von Normalität?
Gewöhnlich zu sein bedeutet, sich im Durchschnitt zu befinden und keine besonderen Eigenschaften oder Fähigkeiten zu haben. Normalität hingegen bezieht sich auf das, was als gesellschaftlich akzeptiert oder erwartet wird. Gewöhnlichkeit ist subjektiver und kann sich auf individuelle Merkmale beziehen, während Normalität eher objektiv und allgemein gültig ist. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **

Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
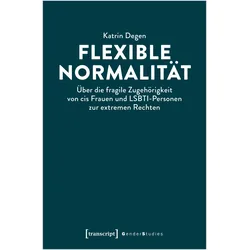
Flexible Normalität, Fachbücher von Katrin DegenWer definiert, was normal ist? Die (extreme) Rechte und ihr Verhältnis zur Normalität sind komplex: Auf den ersten Blick erscheint Normalität als inhärente Eigenschaft, die für ein gutes Leben oder eine gesunde Nation unverzichtbar ist. Was aber, wenn das Abnormale Teil des rechten Kollektivs ist? Katrin Degen rekonstruiert einen solchen diskursiven Aushandlungsprozess anhand nicht-heteronormativer Akteurinnen und Akteure im rechten Kontext und zeigt, dass diese ihre politische Aktivität nicht als Widerspruch beschreiben. Stattdessen passt sich die (extreme) Rechte auf ihre eigene Weise aktuellen Begebenheiten an - was bei der Entwicklung von Interventionen berücksichtigt werden sollte.49,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Nichtehelichkeit als Normalität, Fachbücher von Karin Orth»Unehelichkeit« als Normalität in der Mitte des 19. Jahrhunderts: Eine mikrohistorische Studie über Familie und Sexualität. Ausserhalb der Ehe geborene Kinder stellen heute keine Besonderheit dar. Ganz anders vor 200 Jahren: Im frühen 19. Jahrhundert stieg die Rate der unehelichen Kinder von zuvor zwei bis vier Prozent auf nun über 20 Prozent an, lokal – etwa im Südwesten des Grossherzogtums Baden – sogar auf über 60 Prozent. Dieser enorme Anstieg wurde registriert, vielfach kommentiert und von bürgerlicher wie kirchlicher Seite häufig als bedrohlich empfunden. Karin Orth untersucht an zwei regionalen badischen Fallbeispielen und der Schweizer Metropole Basel die strukturellen Ursachen dieses Anstiegs und zeigt die Praktiken, Erfahrungen und Auswirkungen der »Illegitimität« auf: »Männerbekanntschaften« und der nichteheliche »Beyschlaf«, (verheimlichte) Schwangerschaft und Niederkunft, »Kindsaussetzung« und »Kindsmord« sowie das Gebären im Basler Bürgerspital. Im Zentrum stehen rund 400 ledige junge Frauen aus dem badischen Südwesten. Sie waren mehrheitlich in unterbäuerlichen Familien aufgewachsen, die in Baden »Unehelichkeit« als Normalität lebten, und transferierten dieses Muster der nichtehelichen Familiengründung nach Basel. An ihrem Beispiel wird der Mikrokosmos der »Unehelichkeit« exemplarisch analysiert.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was bedeutet es, gewöhnlich zu sein und wie unterscheidet sich Gewöhnlichkeit von Normalität?
Gewöhnlich zu sein bedeutet, sich im Durchschnitt zu befinden und keine besonderen Eigenschaften oder Fähigkeiten zu haben. Normalität hingegen bezieht sich auf das, was als gesellschaftlich akzeptiert oder erwartet wird. Gewöhnlichkeit ist subjektiver und kann sich auf individuelle Merkmale beziehen, während Normalität eher objektiv und allgemein gültig ist. **
Ähnliche Suchbegriffe für Datenquellen
-
Antisemitismus - die deutsche Normalität, Fachbücher von Hans SteidleDas Buch "Antisemitismus - die deutsche Normalität" von Hans Steidle bietet eine tiefgehende Analyse des Antisemitismus in Deutschland und dessen Verknüpfung mit gesellschaftlichen Strukturen. Es beleuchtet die Singularität der deutschen Tat Auschwitz und stellt diese in den Kontext der bürgerlichen Kälte sowie der spätkapitalistischen Vergesellschaftungsformen. Steidle fordert eine kritische Auseinandersetzung mit der deutschen Geschichte und deren Auswirkungen auf die gegenwärtige Gesellschaft. Durch die Verbindung von historischen und gesellschaftlichen Aspekten wird ein umfassendes Bild des Antisemitismus gezeichnet, das zum Nachdenken anregt und zur Diskussion einlädt. Dieses Fachbuch richtet sich an alle, die sich mit der Thematik des Antisemitismus und dessen gesellschaftlichen Wurzeln auseinandersetzen möchten.26,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Geschenkset - Desert RoutineDieses exklusive Set vereint vier Produkte natürlichen Ursprungs für ein einzigartiges Hautpflegeerlebnis: traditionelle Aleppo-Seife reich an Lorbeerblattöl, pflegende, reine Sheabutter, kostbares Kaktusfeigenkernöl und ein Duschgel mit Jasminduft. Jede Zutat wurde aufgrund ihrer feuchtigkeitsspendenden und regenerierenden Eigenschaften ausgewählt und sorgt für weiche, strahlende und optimal gepflegte Haut. - 1 Traditionelle Aleppo-Seife mit 40 % Lorbeeröl - Reine Sheabutter - Kaktusfeigenkernöl - Duschgel mit Aleppo-Seife und Jasminduft33,25 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
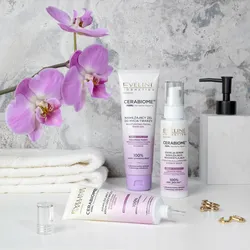
Basic routine setGut mit Feuchtigkeit versorgte, gesunde Haut beginnt mit einer Pflege, die ihre natürliche Balance bewahrt – einer Reinigung, die sanft und effektiv wirkt, intensiver Feuchtigkeitsversorgung und einer Creme, die diese in der Haut einschließt. Das Basic Routine Set aus der Cerabiome Serie ist ein dreistufiges Pflegeritual für jeden Tag, entwickelt für Haut, die intensive Feuchtigkeit und eine gestärkte Schutzbarriere benötigt.12,71 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.